Background to Direct Preference Optimization Your Language Model Is Secretly A Reward Model
Looking for the latest information on Direct Preference Optimization Your Language Model Is Secretly A Reward Model? We've gathered comprehensive data, records, and insights about Direct Preference Optimization Your Language Model Is Secretly A Reward Model.
Important Facts
Explore the key sources for Direct Preference Optimization Your Language Model Is Secretly A Reward Model.
Latest News
Stay updated on Direct Preference Optimization Your Language Model Is Secretly A Reward Model's latest milestones.
Direct Preference Optimization (DPO) - How to fine-tune LLMs directly without reinforcement learning
Direct Preference Optimization (DPO) | Paper Explained
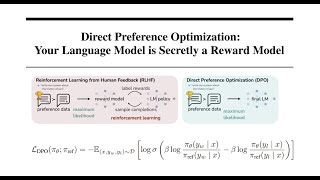
Direct Preference Optimization: Your Language Model is Secretly a Reward Model
Direct Preference Optimization (DPO) vs RLHF Math
Stanford CS234 I Guest Lecture on DPO: Rafael Rafailov, Archit Sharma, Eric Mitchell I Lecture 9
Direct Preference Optimization (DPO) Explained: Aligning LLMs Without Reinforcement Learning
Direct Preference Optimization (DPO) Explained: AI Alignment
Direct Preference Optimization- Your Language Model is Secretly a Reward Model
[short] Direct Preference Optimization: Your Language Model is Secretly a Reward Model
Direct Preference Optimization: Your Language Model is Secretly a Reward Model
Direct Preference Optimization (DPO) Explained | in 2 Minutes
Detailed Analysis
Data is compiled from public records and verified media reports.
Last Updated: September 25, 2026
Summary
For 2026, Direct Preference Optimization Your Language Model Is Secretly A Reward Model remains one of the most searched-for information profiles. Check back for the newest reports.
Disclaimer: Disclaimer: All information is compiled from publicly available data, media reports, and analysis. Actual details may vary.
Summary
Paper found here: arxiv.org/abs/2305.18290. For more information about Stanford's Artificial Intelligence programs visit: stanford.io/ai Stanford CS234 Reinforcement ... How do modern AI systems learn human
Direct Preference Optimization Your Language Model Is Secretly A Reward Model.pdf
What is the most accurate information about Direct Preference Optimization Your Language Model Is Secretly A Reward Model?
Our platform aggregates the most comprehensive and up-to-date insights, ensuring you get relevant details about Direct Preference Optimization Your Language Model Is Secretly A Reward Model.
Why is Direct Preference Optimization Your Language Model Is Secretly A Reward Model trending right now?
Interest in Direct Preference Optimization Your Language Model Is Secretly A Reward Model has surged recently as more people seek reliable resources, related media, and detailed analysis.
Where can I find related media and updates for Direct Preference Optimization Your Language Model Is Secretly A Reward Model?
You can explore extensive galleries, video summaries, and related content directly on this page.
How often is the content about Direct Preference Optimization Your Language Model Is Secretly A Reward Model updated?
We regularly update our database with the latest information, media, and analysis related to Direct Preference Optimization Your Language Model Is Secretly A Reward Model.